
codebase-memory-mcp : un graphe de code pour agents IA
Ce que ce serveur MCP indexe, ce qu'il fait gagner en tokens, ce qu'il coûte en qualité de réponse, et comment le brancher sur Claude Code.
Demandez à un agent de code « qui appelle processOrder ? » sur un projet qu'il ne connaît pas. Il lance un grep, ouvre six fichiers, en lit trois en entier, recommence au tour suivant parce qu'il a oublié. La réponse arrive, mais elle a coûté des dizaines de milliers de tokens et une bonne minute.
codebase-memory-mcp prend le problème à l'envers. C'est un serveur MCP, le protocole qui branche des outils externes sur les assistants IA, qui indexe un dépôt une fois pour toutes dans un graphe : fonctions, classes, imports, routes HTTP et relations d'appel. L'agent interroge ce graphe au lieu de relire le code. La question sur processOrder devient une requête qui répond en moins de 10 millisecondes.
D'où vient le projet
Le dépôt DeusData/codebase-memory-mcp a été créé en février 2026 et dépasse les 46 000 étoiles en octobre. Il est écrit en C, sous licence MIT, et distribué en un seul binaire statique pour macOS, Linux et Windows. Pas de Node, pas de Python, pas de Docker, pas de clé d'API. La dernière version publiée est la v0.11.0, du 15 septembre 2026.
Le choix du C n'est pas une coquetterie. Indexer vite un gros dépôt demande de parser des centaines de milliers de fichiers, et le projet embarque directement les grammaires tree-sitter de 162 langages dans l'exécutable. Les auteurs annoncent le noyau Linux, 28 millions de lignes, indexé en trois minutes sur un Apple M3 Pro.
Un article de recherche accompagne l'outil, publié sur arXiv (2603.27277). C'est assez rare dans l'écosystème MCP pour être signalé : les chiffres ne viennent pas seulement du README.
Ce que contient le graphe
Chaque élément du code devient un nœud, chaque relation une arête. Le serveur expose 17 outils MCP pour exploiter ce graphe. Les plus utiles au quotidien :
| Outil | Ce qu'il fait |
|---|---|
index_repository | Indexe un dépôt, puis le garde à jour tant qu'une session est ouverte dessus |
search_graph | Recherche par nom, par texte (BM25) ou par sens |
trace_path | Remonte les appelants ou descend les appelés, jusqu'à 15 niveaux |
get_architecture | Vue d'ensemble : langages, paquets, routes, points chauds |
detect_changes | Relie un git diff aux symboles touchés et estime le rayon d'impact |
get_code_snippet | Renvoie le code d'une fonction à partir de son nom qualifié |
query_graph | Exécute une requête Cypher en lecture seule |
manage_adr | Lit et modifie les décisions d'architecture stockées avec l'index |
Le projet va plus loin que le code applicatif. Les Dockerfiles, les fichiers Compose, les manifestes Kubernetes et les overlays Kustomize sont indexés eux aussi. trace_path en mode run suit un service Compose jusqu'à son image, puis jusqu'au Dockerfile, puis jusqu'au programme que le conteneur démarre. Pour comprendre une infrastructure héritée, c'est le genre de chemin qu'on reconstitue d'habitude à la main, fichier par fichier.
Pour les requêtes que les outils ne couvrent pas, query_graph accepte un sous-ensemble de Cypher, le langage de requête des bases orientées graphe :
MATCH (f:Function) RETURN f.name LIMIT 5Ce que ça change pour l'agent
Le serveur ne contient aucun modèle de langage. Il fait de l'analyse structurelle et renvoie des résultats bruts. L'intelligence reste dans le client : Claude Code, Codex, Cursor ou n'importe quel agent compatible MCP traduit la question en appels d'outils et met la réponse en forme.
Vous : « qu'est-ce qui appelle ProcessOrder ? »

Agent : trace_path(function_name="ProcessOrder", direction="inbound")

codebase-memory-mcp : parcours du graphe, liste des appelants

Agent : explique la chaîne d'appels en français
C'est la différence avec Trail-code, qui ajoute une mémoire d'équipe aux agents : lui pousse le contexte dans chaque prompt via des hooks, ici c'est l'agent qui décide quand interroger le graphe.
Le gain annoncé tient en deux chiffres, à lire avec leur contexte. Le README cite environ 3 400 tokens pour cinq questions structurelles, contre 412 000 en explorant fichier par fichier, soit 120 fois moins. C'est une comparaison sur cinq requêtes, pas une moyenne. L'étude sur 31 dépôts donne un ordre de grandeur plus prudent : 10 fois moins de tokens et 2,1 fois moins d'appels d'outils.
La même étude publie le chiffre que les partages sur les réseaux oublient : la qualité des réponses. Elle est notée 83 % avec le graphe, contre 92 % en lisant les fichiers. Le graphe va plus vite et coûte moins, mais il perd une partie de ce que la lecture directe attrape : un commentaire qui explique un cas limite, une condition dans le corps d'une fonction. C'est cohérent : un graphe d'appels dit qui parle à qui, pas pourquoi.
J'en tire une règle simple. Le graphe pour s'orienter, la lecture du fichier pour décider. Les agents que l'installeur configure suivent d'ailleurs cette logique, avec trois niveaux : un éclaireur qui fait trois ou quatre requêtes rapides sans jamais affirmer une absence, un vérificateur qui confirme dans le source chaque fichier cité, et un auditeur pour les analyses d'impact complètes.
Installer et brancher sur Claude Code
Sur macOS et Linux, l'installeur tient en une ligne :
curl -fsSL https://raw.githubusercontent.com/DeusData/codebase-memory-mcp/main/install.sh | bashSur Windows, mieux vaut télécharger le script, le lire, puis l'exécuter :
Invoke-WebRequest -Uri https://raw.githubusercontent.com/DeusData/codebase-memory-mcp/main/install.ps1 -OutFile install.ps1
Unblock-File .\install.ps1
.\install.ps1
L'installeur détecte les agents présents sur la machine et configure chacun : l'entrée MCP, des instructions, des skills et des hooks de cycle de vie dans Claude Code. Il annonce 45 intégrations possibles. Si vous préférez garder la main sur votre configuration, l'option --skip-config installe le binaire seul, et l'entrée MCP s'ajoute dans .mcp.json à la racine du projet :
{
  "mcpServers": {
    "codebase-memory-mcp": {
      "command": "/chemin/vers/codebase-memory-mcp",
      "args": []
    }
  }
}
Redémarrer l'agent, taper /mcp : le serveur doit apparaître avec ses 17 outils. Il suffit ensuite de demander « Index this project ». Pour que chaque nouveau projet soit indexé dès la première session :
codebase-memory-mcp config set auto_index trueLes fichiers ignorés suivent trois couches : une liste en dur (.git, node_modules), puis le .gitignore, puis un .cbmignore propre au projet, en syntaxe gitignore.
Tous les outils existent aussi en ligne de commande, ce qui permet de tester sans agent ou de scripter :
codebase-memory-mcp cli index_repository --repo-path /chemin/vers/projet
codebase-memory-mcp cli trace_path --project mon-projet --function-name Search --direction both
L'interface CBM Lens
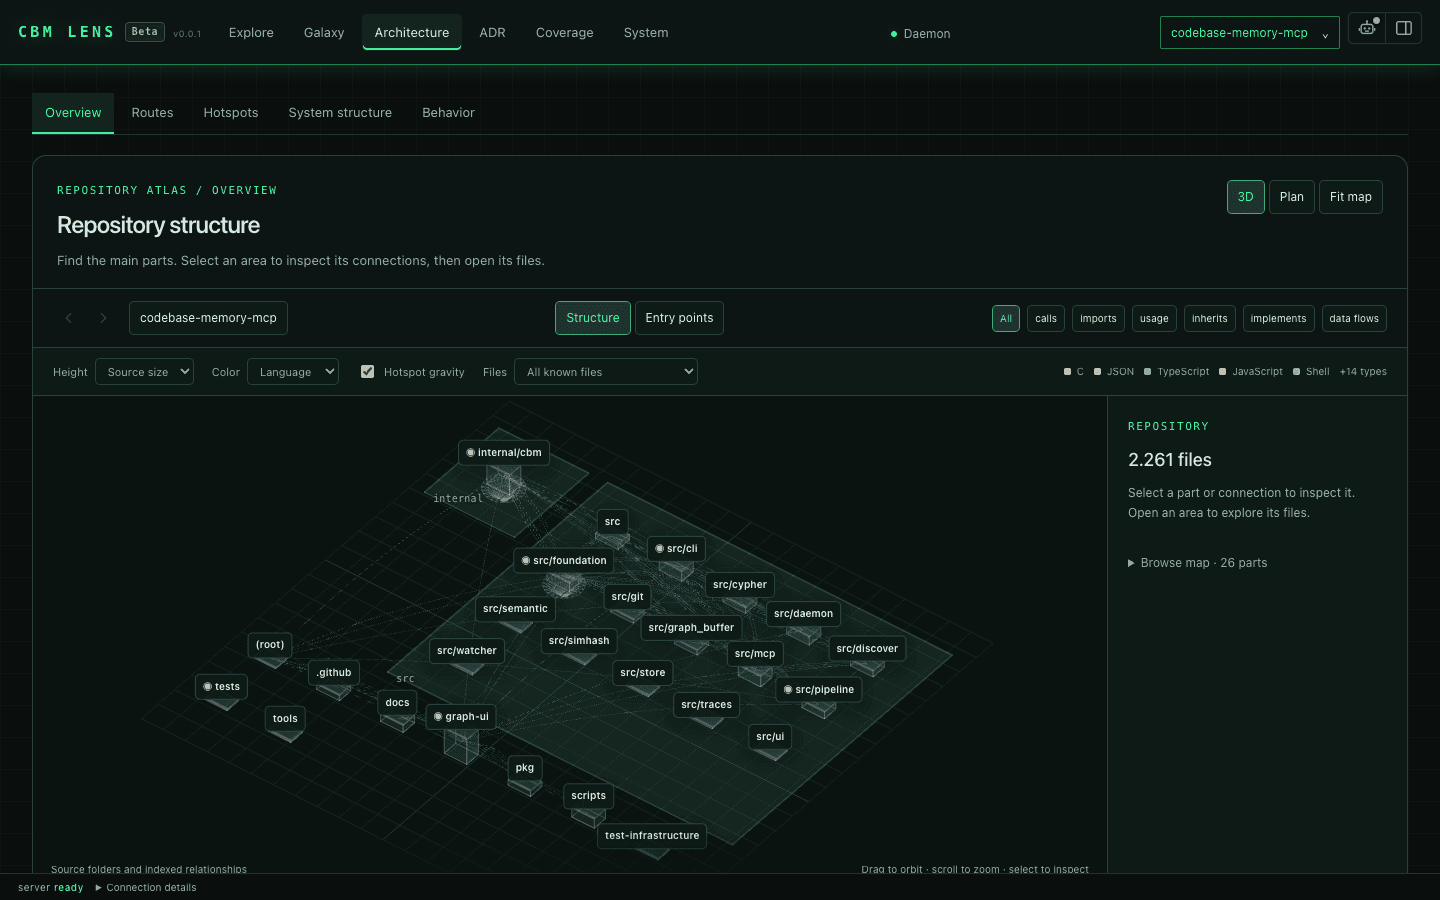
L'image en tête de cet article vient du dépôt : c'est CBM Lens, l'interface web intégrée au binaire. Elle affiche le projet comme une carte 3D où les dossiers deviennent des plateformes, propose une vue « Galaxy » pour naviguer dans le graphe, un lecteur de code basé sur Monaco, et un chat local. Le modèle du chat, Qwen2.5 Coder 0.5B par défaut (environ 567 Mo), tourne dans le navigateur via WebGPU. Rien ne part sur un serveur, sauf le téléchargement initial du modèle depuis Hugging Face.
Une précision qui évite une déception : CBM Lens est en bêta sur la branche main et n'est pas dans la v0.11.0. L'installeur actuel livre encore l'ancienne interface. Pour essayer Lens aujourd'hui, il faut compiler depuis les sources.
Ce qui peut gêner
Microsoft Defender signale parfois le binaire comme Trojan:Script/Wacatac.B!ml. Les auteurs documentent ce faux positif, connu pour toucher aussi gh ou llama.cpp, et la chaîne de publication est sérieuse : scan VirusTotal de chaque version, provenance SLSA niveau 3, signatures Sigstore, sommes SHA-256 vérifiées par l'installeur. Ça reste un exécutable qui lit tout votre code. Vérifier la signature avant de l'installer sur une machine de travail n'a rien de paranoïaque.
L'index local ne quitte pas la machine, ce qui compte si le code est sous contrat de confidentialité. Mais le serveur nourrit un agent, et c'est l'agent qui envoie les extraits au fournisseur du modèle. Le graphe réduit la quantité de code transmise, il ne rend pas l'usage d'un modèle hébergé confidentiel.
Le projet bouge vite. Démon de coordination partagé entre sessions, verrous par projet, règles strictes sur les versions qui peuvent tourner ensemble : la documentation est dense, et tous les processus actifs doivent exécuter exactement la même version. Une mise à jour passe par le script d'installation, relancé à l'identique, puis par un redémarrage de toutes les sessions d'agent ouvertes. Le binaire ne vérifie jamais seul s'il existe une nouvelle version : aucune requête réseau de sa propre initiative, c'est à vous de surveiller les releases.
Enfin, l'intérêt dépend de la taille du projet. Sur un dépôt de quarante fichiers, l'agent lit tout en deux tours et le graphe n'apporte presque rien. Il commence à payer sur une base de code qu'on découvre, un monorepo, ou un projet hérité dont personne ne connaît plus les dépendances. C'est là que l'IA pour les développeurs gagne en coût ce qu'elle perdait en tâtonnements.
codebase-memory-mcp ne rend pas un agent plus intelligent. Il lui donne une carte, ce qui lui évite de visiter chaque pièce pour trouver la cuisine. Sur un gros dépôt, la facture de tokens fond et les réponses arrivent plus vite, au prix de quelques points de précision qu'on récupère en faisant relire les fichiers qui comptent. Si vous n'avez jamais écrit de serveur de ce type, le guide du Model Context Protocol montre comment fonctionnent ces outils que l'agent appelle.