
Gatus : superviser ses services et ses processus en YAML
Gatus surveille vos sites, services, processus et tâches cron depuis un seul fichier YAML, avec une page de statut et des alertes ntfy.
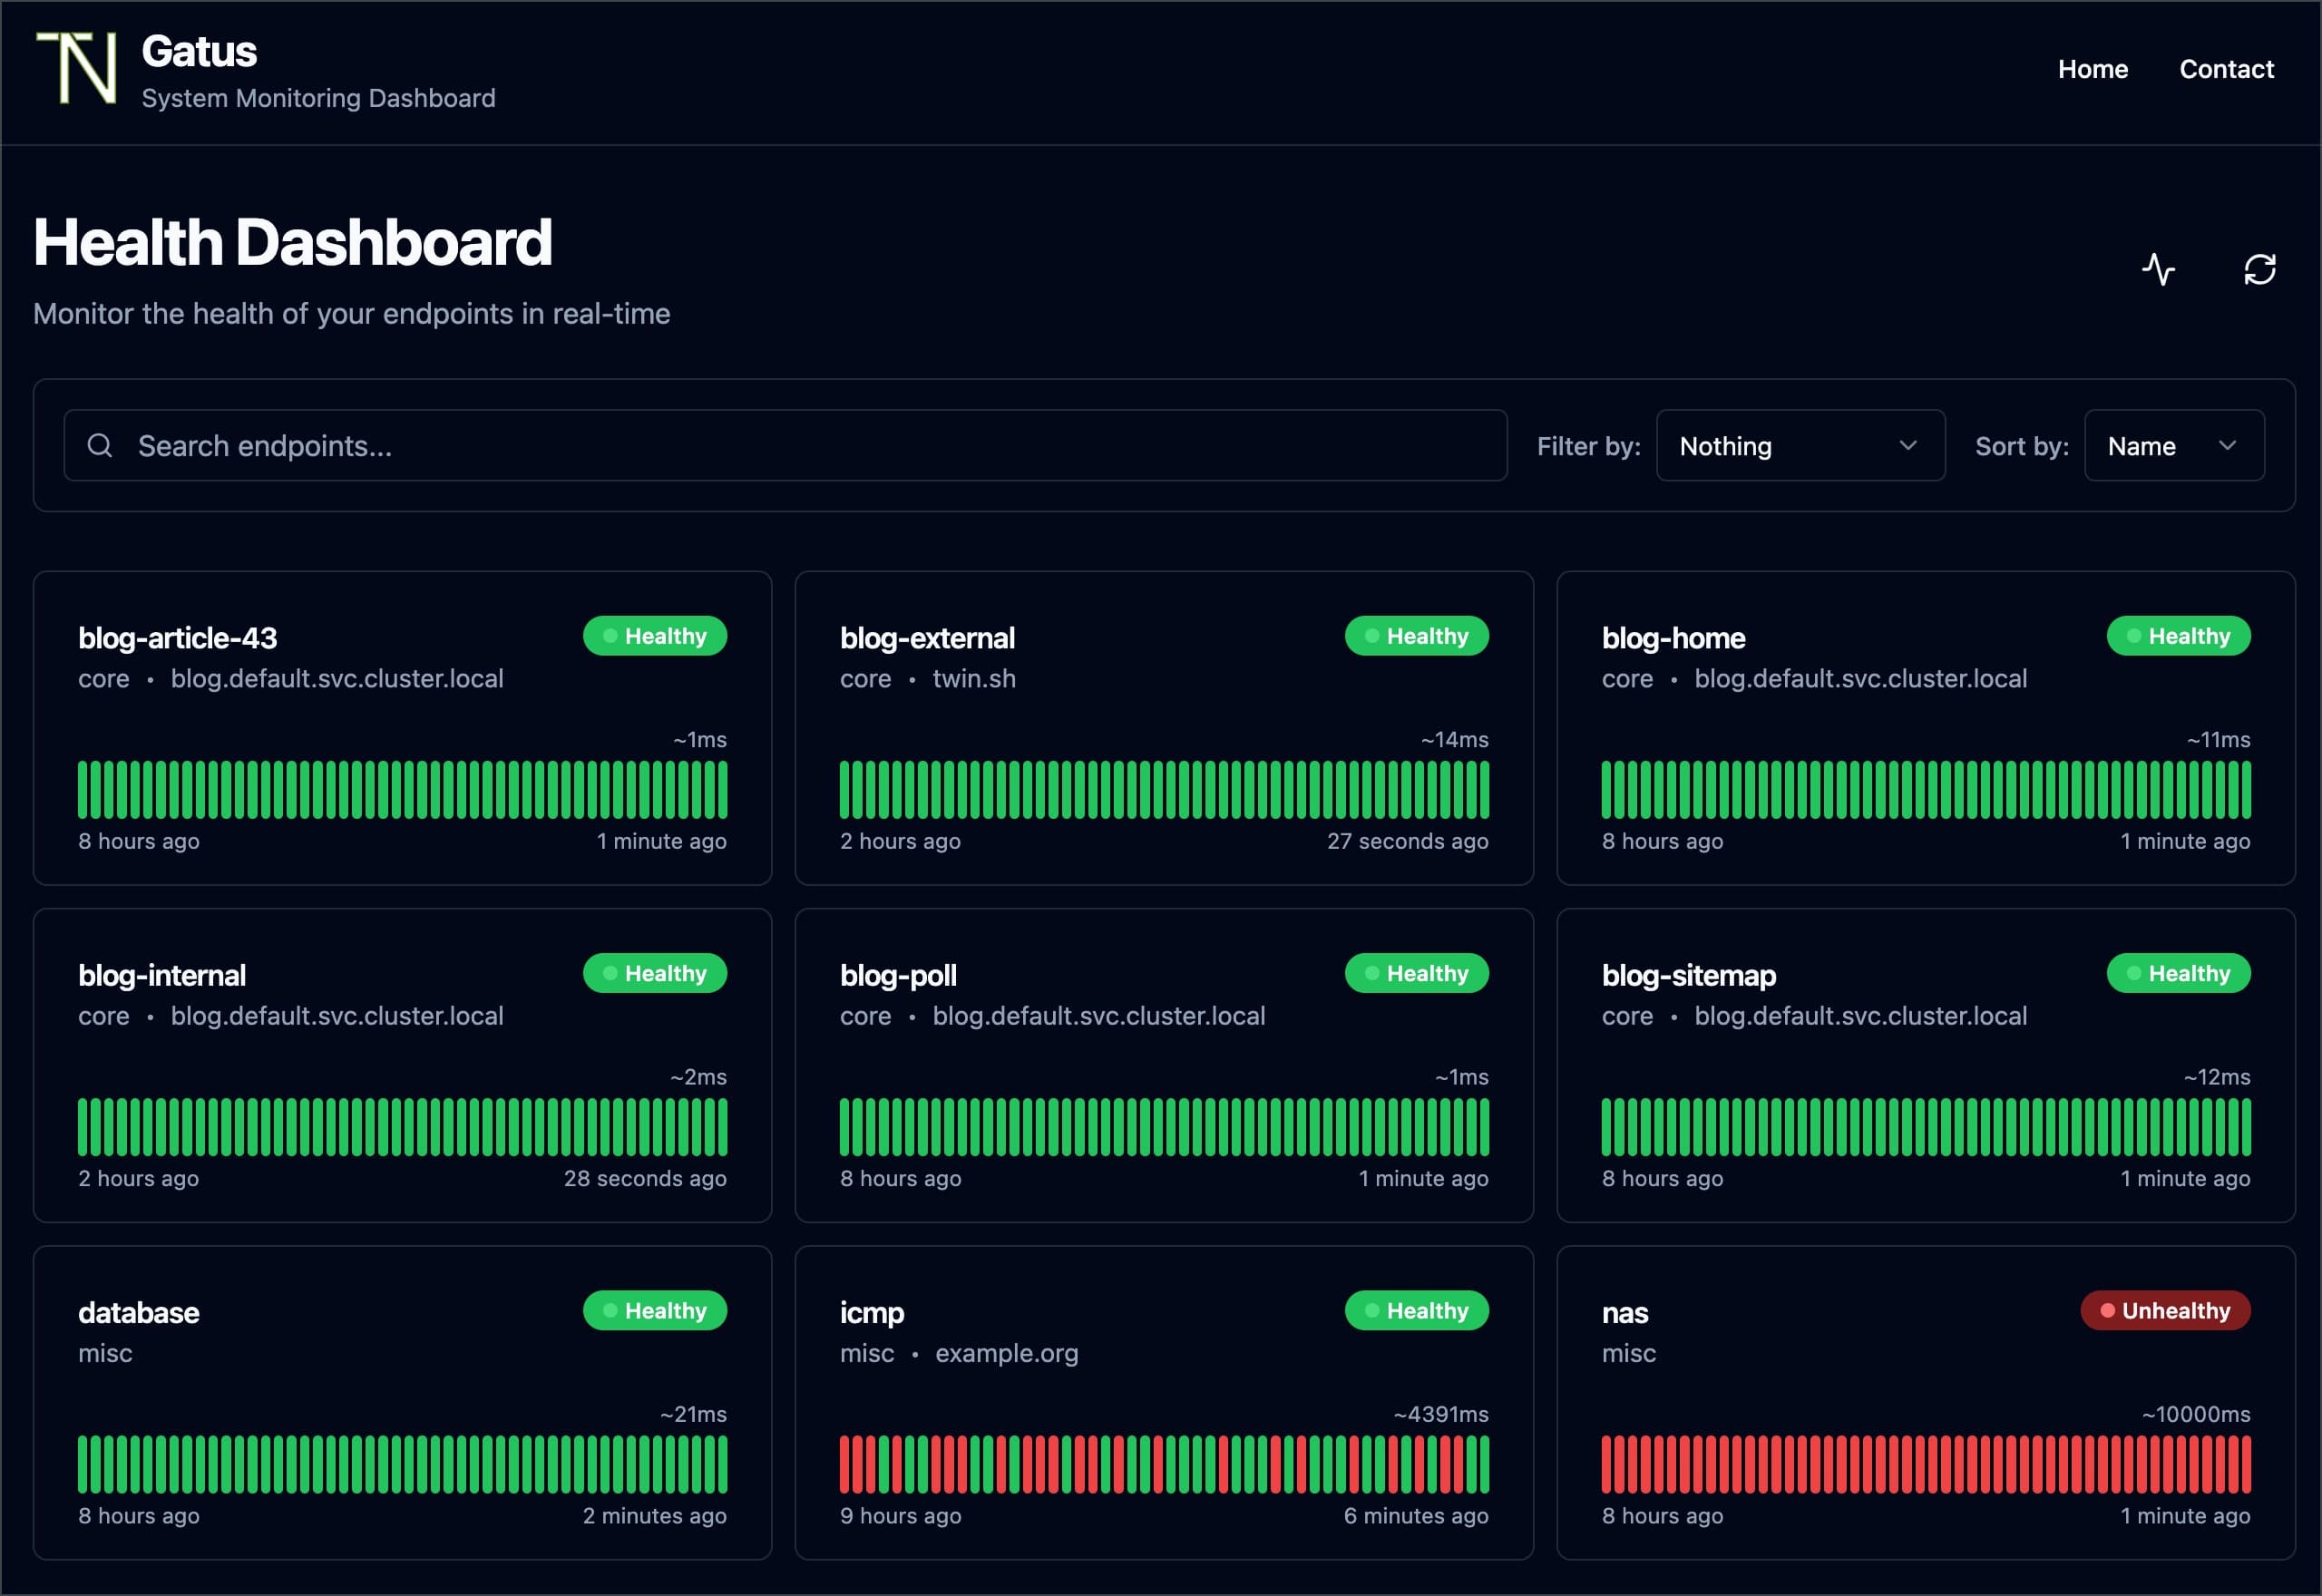
Le pire moment pour découvrir qu'un service est tombé, c'est quand quelqu'un vous le dit. Le scénario classique : une sauvegarde nocturne plante depuis des jours, sans un bruit, parce qu'un disque est plein. Le site répond, le serveur répond, tout a l'air vert. Seul le processus qui compte vraiment ne tourne plus.
Gatus est un outil de supervision open source écrit en Go. Il interroge vos services à intervalle régulier (HTTP, TCP, DNS, SSH…), évalue le résultat avec des conditions que vous écrivez en YAML, affiche une page de statut et envoie une alerte quand une condition échoue. Il sait aussi recevoir des battements de cœur : c'est ce qui permet de surveiller un processus qui n'expose rien, comme un cron ou un script de sauvegarde. Le code source est sur GitHub : TwiN/gatus.
Le projet est sous licence Apache 2.0, approche les 13 000 étoiles, et la dernière version à la date de cet article est la v5.38.0, sortie le 28 octobre 2026.
Pourquoi Gatus plutôt que des métriques
Son auteur pose la question franchement dans la documentation : pourquoi Gatus quand on a déjà Prometheus ou des logs ? Parce qu'une métrique d'erreurs ne bouge pas quand plus aucune requête n'arrive. Si votre reverse proxy tombe, le taux d'erreur de l'application reste à zéro. Ce sont vos utilisateurs qui vous préviennent.
Gatus fait l'inverse. Il va chercher lui-même la réponse, toutes les 30 secondes ou toutes les 5 minutes, et compare ce qu'il reçoit à ce qu'il attend. Pas besoin de trafic réel.
Face à Uptime Kuma, l'autre outil que je recommande souvent, la différence tient en une phrase : Uptime Kuma se configure à la souris, Gatus se configure dans un fichier.
| Gatus | Uptime Kuma | |
|---|---|---|
| Configuration | Fichier YAML, versionnable dans Git | Interface web |
| Conditions | Statut, temps de réponse, corps JSON, certificat, code de sortie SSH… | Statut, mot-clé, temps de réponse |
| Processus sans port | Endpoints externes avec heartbeat | Moniteurs « push » |
| Langage, empreinte | Go, très léger | Node.js, plus gourmand |
| Alertes | Plus de 40 fournisseurs (ntfy, Discord, Slack, Telegram, e-mail…) | Plus de 90 fournisseurs |
Si vous aimez cliquer, Uptime Kuma est très bien. Si vous voulez que votre supervision vive dans le même dépôt que votre infrastructure, relue en pull request et restaurée en une commande, Gatus est fait pour vous.
Installer Gatus avec Docker Compose
Gatus tient dans un seul conteneur. Créez un dossier avec un sous-dossier config et un sous-dossier data :
mkdir -p gatus/config gatus/data
cd gatusservices:
gatus:
image: ghcr.io/twin/gatus:stable
ports:
- "127.0.0.1:8080:8080"
volumes:
- ./config:/config
- ./data:/data
env_file:
- .env
restart: unless-stoppedJe monte le dossier config plutôt que le fichier seul. Gatus recharge sa configuration à chaud quand le fichier change, mais la documentation prévient que la modification peut passer inaperçue quand on monte un fichier unique. Avec le dossier, on édite, on enregistre, c'est pris en compte.
Le tag stable suit la dernière version stable. En production, je préfère épingler une version précise, choisie dans les notes de version.
Premier fichier de configuration, avec un stockage SQLite pour garder l'historique après un redémarrage (par défaut, tout est en mémoire et disparaît) :
storage:
  type: sqlite
  path: /data/data.db

endpoints:
  - name: site
    group: web
    url: "https://monsite.fr/api/health"
    interval: 1m
    conditions:
      - "[STATUS] == 200"
      - "[BODY].status == UP"
      - "[RESPONSE_TIME] < 500"
      - "[CERTIFICATE_EXPIRATION] > 168h"
touch .env
docker compose up -d
docker compose logs -f gatusLa page de statut est sur http://localhost:8080. Chaque endpoint y apparaît avec une barre d'historique : vert quand toutes les conditions passent, rouge dès qu'une seule échoue.
La dernière condition vaut de l'or : elle passe au rouge une semaine avant l'expiration du certificat TLS. Plus de site cassé un dimanche parce que le renouvellement automatique a échoué en silence.
Superviser un processus qui écoute sur un port
Beaucoup de processus n'ont pas de route /health, mais ils écoutent sur un port : une base PostgreSQL, un Redis, un serveur de jeu. Le plus simple est alors de vérifier que la connexion TCP s'établit.
  - name: postgres
    group: base-de-donnees
    url: "tcp://10.0.0.12:5432"
    interval: 30s
    conditions:
      - "[CONNECTED] == true"
      - "[RESPONSE_TIME] < 200"
Si le processus meurt, le port se ferme, [CONNECTED] passe à false. C'est grossier, mais ça couvre déjà le cas le plus fréquent.
Superviser un processus par SSH
Pour un processus qui n'écoute sur rien, ou quand on veut savoir s'il tourne vraiment et pas seulement si un port répond, Gatus peut se connecter en SSH et exécuter une commande. Il récupère alors le code de sortie dans [STATUS] et la sortie standard dans [BODY].
Sur un serveur Linux avec systemd, systemctl is-active fait parfaitement l'affaire : il renvoie 0 si le service tourne, autre chose sinon. Si la commande ne vous est pas familière, les commandes Linux essentielles détaillent systemctl et ps.
  - name: worker-factures
    group: processus
    url: "ssh://10.0.0.12:22"
    ssh:
      username: "gatus"
      password: "${GATUS_SSH_PASSWORD}"
    body: |
      {
        "command": "systemctl is-active --quiet worker-factures"
      }
    interval: 2m
    conditions:
      - "[CONNECTED] == true"
      - "[STATUS] == 0"
Le mot de passe vient du fichier .env, grâce à la substitution des variables d'environnement dans la configuration. Rien de sensible dans le YAML, qui peut donc aller dans Git. Gatus accepte aussi une clé privée via ssh.private-key.
Un conseil : créez un utilisateur gatus dédié, sans droits d'administration. systemctl is-active et pgrep n'ont besoin d'aucun privilège.
Pour un processus lancé hors de systemd, pgrep -x joue le même rôle :
{ "command": "pgrep -x node" }Et comme [BODY] contient la sortie de la commande, on peut aller plus loin. Une commande qui renvoie du JSON permet de tester une valeur précise, par exemple l'espace disque restant, avec [BODY].disque.libre > 10. C'est exactement la condition qui aurait évité la sauvegarde silencieusement cassée du début.
Superviser un cron ou un script avec un heartbeat
Reste le cas le plus piégeux : un processus qui ne tourne que quelques minutes par nuit. Ni port, ni service permanent. On ne peut pas l'interroger, c'est lui qui doit se signaler.
Gatus appelle ça des endpoints externes. Vous déclarez l'endpoint, un jeton, et un intervalle de battement de cœur. Si aucune nouvelle n'arrive dans l'intervalle, Gatus crée lui-même un échec et alerte.
external-endpoints:
  - name: sauvegarde-nocturne
    group: jobs
    token: "${GATUS_TOKEN_SAUVEGARDE}"
    heartbeat:
      interval: 25h
    alerts:
      - type: ntfy
        send-on-resolved: true
À la fin du script, on pousse le résultat avec un simple curl. La clé de l'endpoint suit le format <groupe>_<nom>, ici jobs_sauvegarde-nocturne :
#!/usr/bin/env bash
set -u
debut=$(date +%s)
GATUS="https://statut.monsite.fr/api/v1/endpoints/jobs_sauvegarde-nocturne/external"

if restic backup /srv/donnees; then
  succes=true; erreur=""
else
  succes=false; erreur="restic a echoue (code $?)"
fi

duree="$(( $(date +%s) - debut ))s"
curl -fsS -X POST -G "$GATUS" \
  --data-urlencode "success=$succes" \
  --data-urlencode "error=$erreur" \
  --data-urlencode "duration=$duree" \
  -H "Authorization: Bearer $GATUS_TOKEN_SAUVEGARDE"
Deux pannes sont couvertes d'un coup. Si le script échoue, il le dit (success=false). S'il ne se lance même pas, parce que le cron a sauté ou que la machine est éteinte, le heartbeat de 25 heures expire et l'alerte part quand même. C'est le principe du « dead man's switch ».
Le minimum accepté pour heartbeat.interval est de 10 secondes. Pour un cron quotidien, je mets une marge d'une heure au-dessus de la période.
Et un service Windows ?
Le même mécanisme marche depuis Windows. Mon portail perso tourne comme service Windows grâce à NSSM, sur un PC de la maison qui n'est pas joignable depuis Internet. Si Gatus tourne sur un serveur distant, il ne peut pas l'interroger directement : c'est donc au PC d'envoyer son état.
Une tâche planifiée qui lance ce script toutes les cinq minutes suffit :
$service = Get-Service -Name "Portail"
$ok = $service.Status -eq "Running"
$uri = "https://statut.monsite.fr/api/v1/endpoints/maison_portail/external?success=$($ok.ToString().ToLower())"
if (-not $ok) { $uri += "&error=" + [uri]::EscapeDataString("Service $($service.Status)") }
Invoke-RestMethod -Method Post -Uri $uri -Headers @{ Authorization = "Bearer $env:GATUS_TOKEN_PORTAIL" }
Avec un heartbeat de 15 minutes côté Gatus, l'alerte part si le service s'arrête, mais aussi si le PC entier s'éteint ou perd sa connexion.
Recevoir les alertes sur son téléphone
Une page de statut, personne ne la regarde. Les alertes, si. Gatus en gère plus de quarante, et pour un usage perso je recommande ntfy, les notifications push auto-hébergées : une notification sur le téléphone, sans compte chez personne.
alerting:
  ntfy:
    url: "https://ntfy.monsite.fr"
    topic: "supervision"
    token: "${NTFY_TOKEN}"
    default-alert:
      failure-threshold: 3
      success-threshold: 2
      send-on-resolved: true
Le failure-threshold: 3 évite les fausses alertes : il faut trois échecs d'affilée avant d'être réveillé. Un timeout ponctuel du réseau ne déclenche rien. Le send-on-resolved envoie un second message quand tout revient à la normale, ce qui évite de se lever pour rien.
Il suffit ensuite d'ajouter alerts: [{ type: ntfy }] aux endpoints concernés. La configuration par défaut s'applique, et chaque endpoint peut la surcharger.
Les réglages à connaître
Quelques comportements sont bons à connaître avant de commencer :
- La concurrence : Gatus n'évalue que 3 endpoints en même temps par défaut, pour garder des temps de réponse fiables. Avec beaucoup d'endpoints lents, montez
concurrency. - Le délai d'expiration : 10 secondes par défaut pour HTTP, TCP et ICMP. Une vérification qui dépasse compte comme un échec.
- L'intervalle ne compte pas la durée de la requête : 30 secondes d'intervalle et 2 secondes de réponse donnent un contrôle toutes les 32 secondes.
- Une configuration invalide au rechargement arrête Gatus par défaut. Vérifiez les logs après chaque modification.
L'auteur conseille 5 minutes pour les vérifications complexes et 30 secondes pour celles qui servent à alerter. C'est un bon point de départ.
Gatus ne remplace pas une supervision complète avec métriques et graphiques. Mais pour répondre à la seule question qui compte vraiment, « est-ce que ça tourne ? », c'est l'outil le plus simple que je connaisse. Un fichier YAML, un conteneur, et chaque processus important, du site web au cron de 3 h du matin, a enfin quelqu'un qui le surveille.